Zmęczenie alertami: 82 e-maile w jeden dzień od mojego monitora

Ile alertów powinien wysyłać monitor bezpieczeństwa, który czyta jedna osoba? Według moich liczb mniej więcej jeden e-mail dziennie, plus rzadki wyjątek, który prosi mnie o jakieś działanie. 1 listopada mój monitor przekazał usłudze pocztowej 74 e-maile między północą a 13:32 czasu pacyficznego: 55 o blokadach, które już założył, 16 alertów krytycznych, dwa godzinowe alerty o wolumenie i jeden od skanera na moim Macu.12 Tamtego popołudnia oceniłem, że każdy z nich opisywał rutynowe skanowanie, które krawędź sieci Cloudflare (edge) już zatrzymała;3 w przypadku krytycznych fal zdarzeń sekcja 6 pokazuje, że ta ocena była zbyt łaskawa. Rozwiązaniem okazała się polityka, a nie próg: jeden dzienny digest (zbiorcze podsumowanie), który służy zarazem jako sygnał życia (heartbeat), blokady na czat zamiast na pocztę, alert krytyczny włączany do digestu, gdy krawędź już sobie z nim poradziła, oraz rezultat zapisany przy każdym alercie krytycznym z części chmurowej. Następnego dnia skaner wywołał cztery alerty krytyczne w niecałe sześć minut na moich stronach, a mój monitor nie wysłał w tej sprawie ani jednego e-maila.4 Ten dzień i tak przyniósł 19 e-maili, a nie jeden, i właśnie powód jest najbardziej pożyteczną częścią tej historii.5
Jestem jedynym czytelnikiem poczty z mojego monitora. Gdy skrzynka pokazała 74, zapytałem, czy to rutyna, czy coś prawdziwego, a uczciwa odpowiedź brzmiała: monitor nie potrafił mi tego powiedzieć w tematach wiadomości, bo każdy temat mówił to samo, tylko z inną głośnością.1 Monitor, którego jedyny czytelnik przestaje go czytać, przestał monitorować, niezależnie od tego, co jeszcze wychwytują jego detektory. Dalej znajduje się liczenie, polityka, która je zastąpiła, przypadek testowy i trzy miejsca, w których czysta wersja tej historii się sypie.
TL;DR
- 74 e-maile do 13:32, 82 do północy. Moja własna tabela i liczba wyprowadzona z logów zgadzają się co do 74 sprzed mojej skargi (55 o blokadach, 16 krytycznych, dwa godzinowe, jeden lokalny); cały 1 listopada dał 81 zalogowanych plus jeden digest wysłany przeze mnie ręcznie.125
- 22 z tych 74 nie są udowodnione. Pochodziły z kodu, który logował „sent” (wysłano), nie sprawdzając odpowiedzi usługi pocztowej, więc log dowodzi próby przekazania, a nie tego, że wiadomość dotarła.26
- Literatura miała tę regułę od dawna. Książka Google o SRE dopuszcza trzy rodzaje wyjścia (alerty, tickety i logowanie), mówi „Every page should be actionable” (każde wezwanie powinno wymagać działania) i nazywa alerty e-mailowe „alert spam”; alert The Joint Commission (amerykańskiej organizacji akredytującej szpitale) przytacza szacunek, według którego „between 85 and 99 percent of alarm signals do not require clinical intervention” (od 85 do 99 procent sygnałów alarmowych nie wymaga interwencji klinicznej).78910
- Przypadek testowy zadziałał. 2 listopada jeden adres należący do holenderskiego dostawcy hostingu wywołał cztery alerty krytyczne w ciągu 5 minut i 51 sekund na moich stronach; monitor zablokował go raz, opublikował blokadę na czacie, włączył każdy alert krytyczny do digestu i nie wysłał żadnego e-maila.41112
- Następny dzień i tak przyniósł 19, a nie jeden. Czternaście z nich to krytyczne alerty o fali zdarzeń WAF, w których części zdarzeń nie zapisano ani blokady, ani wyzwania, a ich tematy mówiły „WAF blocks” (blokady WAF) nawet wtedy, gdy krawędź nie zablokowała żadnego ze zdarzeń (dwa razy tego dnia; poprzedniego wieczoru jeden temat mówił „104 WAF blocks”, choć krawędź niczego nie zablokowała ani nie poddała wyzwaniu); moje pierwsze przeredagowanie, z dnia, w którym robiłem te zliczenia, nadal mieszało dwie liczby w jednym wierszu, co wychwyciła recenzja tego wpisu.51314
- Dwa sygnały były błędne. Kontrola podpisu kodu na moim Macu uznała własnego demona Spotlight od Apple za niepodpisaną koparkę kryptowalut, a „RUNS SHORT 162/207” (za mało przebiegów) w digeście okazało się częściowo uśpieniem, częściowo wolniejszym rzeczywistym rytmem uruchomień, a częściowo, sądząc po czasach, trzema przebiegami zabitymi przez watchdog.151617
- Co się zmieniło: jeden digest dziennie niesie sygnał życia, każdą blokadę i rezultat każdego alertu krytycznego z części chmurowej, a od razu e-mailem idą już tylko alert krytyczny nieobjęty żadnym z dwóch warunków włączenia do digestu, godzinowy alert o wolumenie i lokalny skaner; 82 e-maile z 1 listopada zamieniły się w 19 z 2 listopada.185
1. Skrzynka 1 listopada
1 listopada o 13:32 czasu pacyficznego napisałem do sesji agenta, która obsługuje moją infrastrukturę: e-maile z monitora zasypują mi skrzynkę; czy jest coś do zmiany i czy to rzeczy rutynowe, czy prawdziwe zagrożenia?1 Tabela, którą prowadziłem tamtego popołudnia, liczyła 74 e-maile od północy według nadawcy: 55 powiadomień po jednym na blokadę, 16 alertów krytycznych, dwa godzinowe alerty o wolumenie i jeden alert krytyczny od skanera na moim Macu.1
Liczenie opiera się na regule, więc podaję ją przed liczbami. E-mail to na potrzeby tego wpisu wiersz w logu monitora, który zapisuje przekazanie wiadomości usłudze pocztowej. Skrypt przeszedł przez sześć plików logów z okresu od 31 października do 2 listopada i sklasyfikował każdy taki wiersz według strumienia i wyniku.5 Uruchomiony do 13:32 skrypt zgadza się z moją tabelą strumień po strumieniu: 55, 16, dwa i jeden, razem 74.2 Cały lokalny dzień, do północy, dał 81 zalogowanych e-maili (55 o blokadach, 22 krytyczne, trzy godzinowe, jeden lokalny), plus jeden digest wysłany przeze mnie ręcznie o 13:48, który nie ma wiersza wysyłki w logu monitora, łącznie 82.51
W tej zgodności liczą się dwa szczegóły. Moja tabela mówiła o alertach krytycznych „9 before the fold went live at 00:30 PT; the 7 after” (9 przed uruchomieniem włączania o 00:30 PT; 7 po nim); log ma 11 krytycznych wierszy „sent” przed 00:30 i pięć po, a pierwszy alert krytyczny włączony do powiadomienia o blokadzie pojawia się o 00:54:43, po tym jak zmiana wprowadzająca włączanie trafiła na produkcję o 00:46 PDT, a nie o 00:30, jak podawała moja tabela.218 Sumy się zgadzają; podział, który zapisałem ręcznie, mylił się o dwa. Drugi szczegół jest poważniejszy. Z tych 74 aż 22 (10 o blokadach, 11 krytycznych, jeden godzinowy) pochodziły od nadawców, którzy wyrzucali odpowiedź usługi pocztowej, a potem logowali „sent” bez względu na to, co wróciło.26 Poprawka z 01:04 PDT tego ranka, zanim cofnięto zegary, sprawiła, że nadawcy części chmurowej logują status HTTP usługi i piszą „sent” tylko przy odpowiedzi 2xx; nadawca lokalnego skanera zapisuje gołe „Critical email sent” (wysłano e-mail krytyczny) i robi to tylko wtedy, gdy żądanie nie zgłosiło błędu.6 Te 22 wcześniejsze wiersze dowodzą, że monitor próbował; nie dowodzą, że usługa pocztowa cokolwiek przyjęła. Mój log z 31 października oceniał, że e-maile z chmury „most likely were” (najprawdopodobniej zostały) doręczone, co jest rozsądnym przypuszczeniem, ale wciąż przypuszczeniem.19
Nawet 2xx dowodzi mniej, niż sugeruje słowo „sent”. Dokumentacja Resend definiuje zdarzenie email.sent jako „Occurs whenever the API request was successful. Resend will attempt to deliver the message to the recipient’s mail server” (występuje, gdy żądanie do API się powiodło; Resend spróbuje doręczyć wiadomość na serwer pocztowy odbiorcy), a doręczenie wymienia jako osobne, późniejsze zdarzenie.20 Samo wywołanie wysyłki odpowiada identyfikatorem id.21 Każda liczba poniżej to liczba przekazań, które usługa pocztowa przyjęła, albo, w przypadku 22 z 1 listopada i 10 z 31 października, łącznie 32, przekazań, których monitor próbował.5 Żadna z nich nie jest liczbą wiadomości, które przeczytałem.
W rozbiciu na godziny dzień wygląda jak urwisko i płaskowyż.
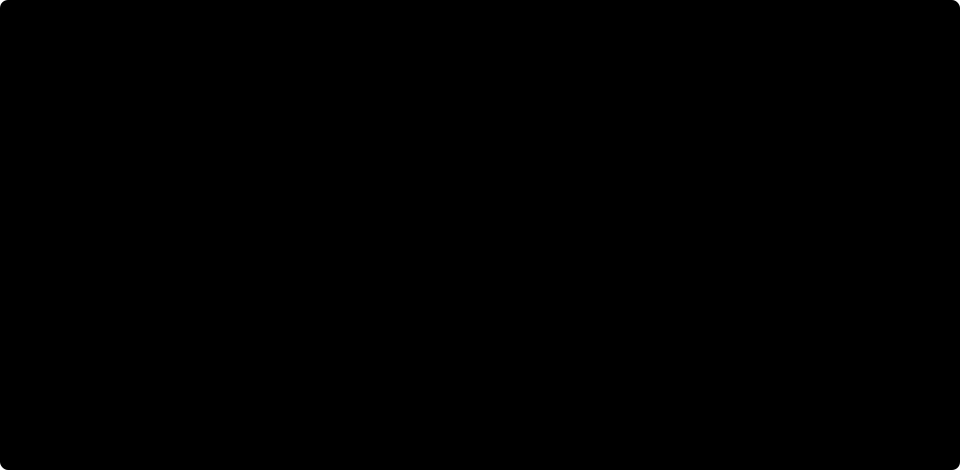
1 listopada, czas lokalny: e-maile na godzinę w zestawieniu z alertami, które nie stały się e-mailem, z zaznaczoną zmianą polityki o 13:50.22
Pierwsza godzina przyniosła 22 e-maile, wszystkie z niezweryfikowanego kodu (10 o blokadach, 11 krytycznych, jeden godzinowy).22 Od tego momentu powiadomienia o blokadach szły w tempie od jednego do pięciu na godzinę, bo krawędź wciąż blokowała skanery, a każda blokada pisała do mnie list. Ostatni e-mail o blokadzie wyszedł o 13:25:57; pierwsze powiadomienie o blokadzie włączone zamiast tego do digestu pojawia się o 14:20:35.22 Po zmianie z 13:50 liczba e-maili spada do zera do dwóch na godzinę, podczas gdy alerty włączone do digestu i wyciszone rosną do nawet 23 na godzinę.22 Ruch nie zmalał. Zmalała poczta.
Poprzedni dzień to kiepski punkt odniesienia. Mój log z 1 listopada mówi „Yesterday had 10” (wczoraj było 10) i skrypt się z tym zgadza, ale log z 31 października zaczyna się o 22:31, wieczorem, gdy ponownie uzbroiłem monitor, więc te 10 e-maili obejmuje 89 minut.15 W mojej ocenie 74 zmierzyło pracę detektora przez pełny dzień internetowego tła, a nie zmianę w zachowaniu skanerów.
2. Do czego służyły alerty
Monitor ma dwie połowy. Część chmurowa uruchamia się według harmonogramu na moim Macu co pięć minut i pobiera z Cloudflare zdarzenia firewalla oraz zgrupowane liczniki żądań dla każdej z moich stref: które adresy trafiły w które ścieżki, jak często i jaką akcję krawędź podjęła wobec każdego zdarzenia.1823 Właściwą ramę dla tych danych daje własny opis Cloudflare: „Security Events displays information about requests actioned or flagged by Cloudflare security products, including features such as Browser Integrity Check” (Security Events wyświetla informacje o żądaniach, wobec których produkty bezpieczeństwa Cloudflare podjęły działanie lub które oznaczyły, w tym przez funkcje takie jak Browser Integrity Check).24 Część lokalna to skaner, który co 10 minut sprawdza samego Maca w kolejnych poziomach: procesy i ich podpisy kodu, hooki agentów na maszynie, narzędzia przesłaniające binaria systemowe w ścieżce wyszukiwania i tym podobne.12
To, co część chmurowa robi z danymi, łatwo opisać. Zgłasza wykrycia według ważności (krytyczna, wysoka, średnia) i kategorii, a przy krytycznym zgłoszeniu próbuje zadziałać, zanim komukolwiek powie: gdy za wystarczającą liczbą zdarzeń stoi jeden adres, dodaje go na siedem dni do listy blokad obejmującej całe konto, którą każda strefa egzekwuje na krawędzi.124 Do zmian z 1 listopada każda z tych akcji generowała też e-mail, podobnie jak każdy alert krytyczny, którego nie wyciszył dwugodzinny limit na stronę i kategorię, koniec każdej sesji i każda godzina z dużą liczbą blokad.185 Lokalny skaner zgłasza własne wykrycia i sam wysyła e-mailem swoje alerty krytyczne.25 Alerty samego Cloudflare występują w dwóch odmianach, „Monitors that you define yourself, and Platform Notifications” (monitory definiowane samodzielnie i powiadomienia platformy): zaplanowane zapytania SQL API i wstępnie skonfigurowane alerty produktowe, jedne i drugie ustawiane w panelu.26 Mój nie jest żadnym z nich: to skrypt na moim Macu, który sam czyta zdarzenia firewalla, co oznacza również, że szum jest moim problemem do naprawienia.
3. Co literatura już mówiła
Nic z tego, co poniżej, nie jest nowe, i to jest ta niewygodna część. Większość tych tekstów czytałem, a mimo to zbudowałem monitor wysyłający e-mail na każde zdarzenie.
Trzy rodzaje wyjścia, a e-mail nie jest żadnym z nich. Wstęp do Site Reliability Engineering (książki Google o inżynierii niezawodności serwisów) mówi „There are three kinds of valid monitoring output” (istnieją trzy rodzaje prawidłowego wyjścia monitoringu): alerty, które „Signify that a human needs to take action immediately” (oznaczają, że człowiek musi natychmiast podjąć działanie); tickety, które „Signify that a human needs to take action, but not immediately.” (oznaczają, że człowiek musi podjąć działanie, ale nie natychmiast); oraz logowanie, gdzie „No one needs to look at this information, but it is recorded for diagnostic or forensic purposes.” (nikt nie musi na te informacje patrzeć, ale są zapisywane do celów diagnostycznych lub śledczych).7 Ta sama strona bez ogródek ocenia projekt, który miałem: „a system that requires a human to read an email and decide whether or not some type of action needs to be taken in response is fundamentally flawed” (system wymagający od człowieka przeczytania e-maila i zdecydowania, czy trzeba w odpowiedzi coś zrobić, jest z gruntu wadliwy).7 Przy takim podziale moje 55 e-maili o blokadach było logowaniem dostarczanym jako alerty. Krawędź już zadziałała; człowiekowi nie zostało nic do zrobienia.
Każde wezwanie powinno wymagać działania. Rozdział Roba Ewaschuka o monitorowaniu w tej samej książce definiuje alert jako „A notification intended to be read by a human and that is pushed to a system such as a bug or ticket queue, an email alias, or a pager” (powiadomienie przeznaczone do przeczytania przez człowieka, wypychane do systemu takiego jak kolejka błędów lub ticketów, alias e-mailowy albo pager), a jego przypis o odmianie e-mailowej brzmi „Sometimes known as “alert spam,” as they are rarely read or acted on.” (czasem nazywane „alert spam”, bo rzadko się je czyta lub na nie reaguje).9 Reguły rozdziału dotyczące wezwań mieszczą się w trzech wierszach: „Every page should be actionable.” (każde wezwanie powinno wymagać działania) „I can only react with a sense of urgency a few times a day before I become fatigued.” (z poczuciem pilności mogę zareagować tylko kilka razy dziennie, zanim się zmęczę) „If a page merely merits a robotic response, it shouldn’t be a page.” (jeśli wezwanie zasługuje jedynie na mechaniczną reakcję, nie powinno być wezwaniem).8 Moją mechaniczną reakcją na e-mail o blokadzie było jego usunięcie. Rozdział nazywa też koszt szumu: „When pages occur too frequently, employees second-guess, skim, or even ignore incoming alerts, sometimes even ignoring a “real” page that’s masked by the noise.” (gdy wezwania przychodzą zbyt często, pracownicy powątpiewają, przeglądają pobieżnie albo wręcz ignorują przychodzące alerty, czasem nawet „prawdziwe” wezwanie ukryte w szumie).27 Opisuje też zespół, który „spent significant amounts of time triaging the alerts to find the few that were really actionable” (poświęcał mnóstwo czasu na segregowanie alertów, by znaleźć tych kilka, które naprawdę wymagały działania), co dość wiernie opisuje moje popołudnie 1 listopada.28
Objawy zamiast przyczyn i test dla wezwania. Wcześniejszy esej Ewaschuka, który według autora stał się fundamentem tamtego rozdziału, ściska test do jednego zdania: „Pages should be urgent, important, actionable, and real.” (wezwania powinny być pilne, ważne, wymagające działania i prawdziwe).29 O przyczynach mówi „Include cause-based information in symptom-based pages or on dashboards, but avoid alerting directly on causes” (informacje o przyczynach należy umieszczać w wezwaniach opartych na objawach lub na pulpitach, ale unikać alertowania bezpośrednio na przyczyny), w sekcji zatytułowanej „Cause-based alerts are bad (but sometimes necessary)” (alerty oparte na przyczynach są złe, choć czasem konieczne).29 Blokadę firewalla traktuję jako fakt na poziomie przyczyny: skaner trafił na regułę. Objaw, który mnie obchodzi, to wrażliwa ścieżka, która została zaserwowana, albo strona, która leży, a w mojej ocenie żaden z tych 74 nie zgłaszał ani jednego, ani drugiego; żądania do sondowanych ścieżek z tamtego dnia nie pokazały żadnego 2xx na wrażliwej ścieżce.3 Esej przewiduje też digest: „A daily (or more frequent) report can work too” (dzienny lub częstszy raport też może się sprawdzić), z ostrzeżeniem, że „without a system of accountability this amounts to less-spammy email alerts” (bez systemu odpowiedzialności sprowadza się to do nieco mniej spamerskich alertów e-mailowych).30 Jego lekarstwem jest człowiek: „make sure the oncall person (or someone else) is designated to triage these every day” (trzeba zadbać, by osoba dyżurna, albo ktoś inny, była wyznaczona do codziennego segregowania tych raportów).30 Przy monitorze dla jednej osoby tą osobą mogę być tylko ja. Pole rezultatu z sekcji 4 to mój własny mechanizm pomocniczy, nie jego: daje codziennej segregacji coś do sprawdzenia, czyli co stało się z każdym alertem krytycznym, ale samej segregacji nie wykonuje.
Precyzja i czułość. Rozdział o alertowaniu w The Site Reliability Workbook (praktycznym towarzyszu książki o SRE) daje słownictwo do opisu tego, co poszło nie tak. Precyzja to „The proportion of events detected that were significant.” (odsetek wykrytych zdarzeń, które były istotne). Czułość to „The proportion of significant events detected.” (odsetek istotnych zdarzeń, które wykryto).31 Nie zmierzyłem czułości mojego monitora, bo wymaga to policzenia istotnych zdarzeń, które przeoczył, a sekcja 5 opisuje jedno z nich. Jako strumień poczty miał precyzję bliską zeru: 74 e-maile i, w mojej ocenie, żadna wiadomość wśród nich nie prosiła mnie o działanie. Ten sam rozdział nazywa czas resetu, „How long alerts fire after an issue is resolved. Long reset times can lead to confusion or to issues being ignored.” (jak długo alerty się odpalają po rozwiązaniu problemu; długie czasy resetu mogą prowadzić do dezorientacji lub ignorowania problemów).31 Czas resetu zdefiniowano dla alertów, które odpalają się dalej; e-mail o blokadzie odpala się raz i potem nie przynosi żadnej aktualizacji o rozwiązaniu: nigdy nie mówi, że skaner odszedł.
Szpitalna wersja tej samej porażki. Sam rozdział o SRE wskazuje poza oprogramowanie, na zarządzanie alarmami kardiologicznymi, „for an example of alert fatigue in another context.” (jako przykład zmęczenia alertami w innym kontekście).28 Sentinel Event Alert The Joint Commission o bezpieczeństwie alarmów urządzeń medycznych, wydany 8 kwietnia 2013, podaje liczby: „The number of alarm signals per patient per day can reach several hundred” (liczba sygnałów alarmowych na pacjenta dziennie może sięgać kilkuset) oraz „It is estimated that between 85 and 99 percent of alarm signals do not require clinical intervention” (szacuje się, że od 85 do 99 procent sygnałów alarmowych nie wymaga interwencji klinicznej).10 Alert jest ostrożny w sposób wart naśladowania: przedział od 85 do 99 procent obejmuje alarmy niewymagające interwencji, nie tylko fałszywe, i alert ich nie rozdziela. Konsekwencja, którą odnotowuje, to ta, w którą sam już wchodziłem: personel kliniczny „become desensitized or immune to the sounds” (staje się znieczulony lub odporny na dźwięki) i „may turn down the volume of the alarm, turn it off, or adjust the alarm settings outside the limits that are safe and appropriate for the patient” (może ściszyć alarm, wyłączyć go albo ustawić poza granicami bezpiecznymi i właściwymi dla pacjenta).10 Alert liczy 98 zdarzeń związanych z alarmami od stycznia 2009 do czerwca 2012, z których 80 „resulted in death” (zakończyło się śmiercią), a poza czynnikami zgłoszonymi do swojej bazy danych nazywa zmęczenie alarmami „the most common contributing factor.” (najczęstszym czynnikiem przyczyniającym się).10 U mnie stawka jest nieporównanie niższa. Mechanizm jest ten sam: człowiek, który uczy się, że alarmy go nie potrzebują, uczy się tego również o następnym, prawdziwym.
NIST dawniej i dziś. Wersja z 2012 roku przewodnika NIST po obsłudze incydentów, SP 800-61r2, ostrzegała, że „it is not uncommon for an organization to receive thousands or even millions of intrusion detection sensor alerts per day.” (nierzadko organizacja otrzymuje tysiące, a nawet miliony alertów z czujników wykrywania włamań dziennie).32 Wersja z kwietnia 2025, SP 800-61r3, która „supersedes SP 800-61r2” (zastępuje SP 800-61r2), usuwa to zdanie; najbliższy mu fragment to zalecenie, że „The volume of potentially adverse events to be analyzed is generally quite high, so organizations should rely on technical solutions that filter large event datasets down to a subset that is suitable for human viewing and analysis.” (liczba potencjalnie niekorzystnych zdarzeń do analizy jest zwykle wysoka, więc organizacje powinny polegać na rozwiązaniach technicznych, które filtrują duże zbiory zdarzeń do podzbioru nadającego się do przeglądu i analizy przez ludzi).33 Filtr traktuję jako zalecenie, a digest jako jeden z filtrów.
Jedna ankieta dostawcy, oznaczona jako taka. Ankieta Vectra AI z 2023 roku, przeprowadzona przez Sapio Research wśród 2000 analityków bezpieczeństwa, podaje, że „SOC teams receive an average of 4,484 alerts per day, and over two-thirds (67%) of them are ignored.” (zespoły SOC otrzymują średnio 4484 alerty dziennie, a ponad dwie trzecie z nich, 67%, jest ignorowanych).34 To zamówiona przez dostawcę ankieta opinii, a 67 procent to deklaracje respondentów, nie pomiar. Przytaczam ją tylko w jednej sprawie: ta porażka występuje także w małej skali. Analitycy deklarują, że ignorują dwie trzecie z 4484 alertów dziennie, a jeden czytelnik bez zespołu przestał czytać przy 74.
4. Nowy projekt w formie reguł
Zmiana weszła 1 listopada o 13:50, 18 minut po mojej wiadomości, a druga zmiana o 14:00 zaostrzyła jeden z jej warunków.18 Zapisałem ją jako reguły, każdą z uzasadnieniem.
Reguła 1: jeden digest dziennie, i to on jest sygnałem życia. Pierwszy przebieg monitora po 07:00 czasu lokalnego wysyła jeden e-mail obejmujący okno od poprzedniego digestu.1835 Własny opis digestu mówi, co ten e-mail zastępuje: „One email a day … in place of an email per auto-block and per WAF-handled CRITICAL.” (jeden e-mail dziennie… zamiast e-maila na każdą automatyczną blokadę i każdy CRITICAL obsłużony przez WAF).35 Otwiera go stan przebiegów (zarejestrowane przebiegi, przebiegi rozpoczęte i zakończone, awarie, wysłane i wyciszone e-maile krytyczne), dalej automatyczne blokady ze strefą, powodem i operatorem sieci, każdy alert krytyczny i jego los, wykrycia według ważności i kategorii, sondowane ścieżki oraz nierozwiązane zgłoszenia lokalnego skanera.12 Powodem istnienia digestu jest skrzynka. Powód wysyłania go codziennie stoi w tym samym opisie: „The digest is also the heartbeat: it goes out on a quiet day too” (digest jest też sygnałem życia: wychodzi również w spokojny dzień).35 Strumień alertów, który odzywa się tylko wtedy, gdy coś się dzieje, nie pozwala mi odróżnić spokojnego dnia od martwego monitora. Digest, który zawsze przychodzi, na to pozwala: cisza oznacza awarię, a nie spokój. Notatki samego programu odnotowują, dlaczego mi na tym zależy: wcześniej w 2026 roku monitor był martwy przez miesiące i nic tego nie zauważyło.35
Reguła 2: blokady idą na czat, nie na pocztę. Notatki projektowe ujmują to w czterech słowach: „Per block: Slack only.” (na blokadę: tylko Slack).3 Blokada to krawędź działająca w moim imieniu. W kategoriach książki o SRE to logowanie: zapisane, przydatne później i niewymagające działania człowieka.7 Czat zachowuje strumień na żywo na chwile, gdy chcę go obserwować, a digest zachowuje zapis.
Reguła 3: alert krytyczny trafia do digestu, gdy krawędź już go obsłużyła. Alert krytyczny nadal najpierw próbuje zablokować; potem monitor decyduje, czy zasługuje on na e-mail.3 Do digestu zamiast tego włączają go dwa warunki, sprawdzane w tej kolejności. Pierwszy: własny adres zgłoszenia oraz każdy adres w nim kwalifikujący się do automatycznej blokady jest już na aktywnej liście blokad, więc krawędź już teraz zatrzymuje te adresy.314 Ten test nie patrzy na żaden inny adres i działa przed zbadaniem próbki, więc fala włączona do digestu na jego podstawie może nadal zawierać zdarzenia bez zapisanej blokady czy wyzwania, pochodzące z adresów poniżej progu blokady; ta gałąź mówi, że cele respondera są zablokowane, a nie że każde zdarzenie zostało zneutralizowane. Drugi warunek dotyczy fali zdarzeń WAF, czyli serii zdarzeń firewalla w jednej strefie: włącza ją do digestu tylko wtedy, gdy każde zdarzenie w próbce, od bota czy nie, ma zapisaną blokadę lub wyzwanie, a próbka jest kompletna. „A solved or bypassed challenge, log, allow and skip all count as unmitigated.” (rozwiązane lub obejście wyzwania, log, allow i skip liczą się jako niezneutralizowane).3 Definicje Cloudflare wyjaśniają, dlaczego te cztery przemawiają przeciw włączeniu: po wyzwaniu „If successful, Cloudflare accepts the matched request” (jeśli się powiedzie, Cloudflare przyjmuje dopasowane żądanie), a akcja log jedynie „Records matching requests in the Cloudflare Logs.” (zapisuje pasujące żądania w Cloudflare Logs).36 Zgłoszenie uporczywego skanera, które liczy wyłącznie zdarzenia zablokowane lub poddane wyzwaniu przez krawędź, trafia do digestu na podstawie warunku WAF właśnie z tego powodu albo na podstawie warunku listy blokad, gdy jego adres jest już na liście, jak było w przypadku zgłoszenia z 2 listopada.3 Wszystko inne idzie e-mailem od razu.
Reguła 4: rezultat zapisuje się przy zgłoszeniu. Zasada jest taka, że każdy alert krytyczny z części chmurowej niesie jeden zapisany rezultat: włączony do digestu, bo adres jest na liście blokad; włączony do digestu, bo krawędź zablokowała lub poddała wyzwaniu każde zdarzenie z próbki; wysłany e-mailem; wyciszony (w ramach limitu jednego e-maila na stronę i kategorię co dwie godziny); albo nieudana wysyłka e-maila.337 Zapis nie dorównuje zasadzie. Spośród alertów krytycznych z datą 1 listopada w UTC 118 nie ma rezultatu: 117 zgłoszono, zanim pole istniało, a jeden alert krytyczny z chmury, o 14:13 PST, pojawił się już po zmianie; jego przebieg był jednym z trzech z sekcji 7, które zakończyły się około czterech minut po starcie, i zatrzymał się w trakcie automatycznej blokady, zanim zapisano rezultat. Alerty krytyczne lokalnego skanera nigdy go nie mają; trzy z 2 listopada nie mają żadnego.3738 Od 3 listopada monitor zapisuje przy alercie krytycznym „pending” (w toku), zanim uruchomi automatyczną blokadę, więc przebieg przerwany w połowie zostawia widoczny stan zamiast pustego pola.14 Digest drukuje rezultat obok każdego alertu krytycznego z chmury pod nagłówkiem, który to obiecuje: „Every CRITICAL and what became of it” (każdy CRITICAL i co się z nim stało).12 Pole rezultatu to mój mechanizm, nie Ewaschuka. Jego warunkiem dla dziennego raportu jest osoba wyznaczona do codziennej segregacji, a tutaj tą osobą jestem ja; pole daje tej segregacji coś do sprawdzenia.30 Z rezultatem w każdym wierszu digest odpowiada na pytanie, które zadałem 1 listopada, rutyna czy coś prawdziwego, alert po alercie, choć „wysłany e-mailem” czy „włączony do digestu” mówi, dokąd trafił alert krytyczny, a nie że cokolwiek zostało rozwiązane.
Reguła 5: godzinowy alert o wolumenie zostaje. Znów notatki: „Hourly volume alert (responder): still immediate, at most once an hour” (godzinowy alert o wolumenie od respondera: nadal natychmiastowy, najwyżej raz na godzinę).3 Pojedyncza blokada to rutyna; nagły stos blokad w ciągu godziny to najbliższy objawowi sygnał, jaki ma część chmurowa, czyli zmiana w tym, co internet mi robi. 2 listopada odpalił raz.5
Reguła 6: alerty krytyczne lokalnego skanera nadal idą e-mailem od razu. Notatki projektowe utrzymują je jako natychmiastowe, bo z założenia mają być rzadkie.3 Ja trzymam je z drugiego powodu: nic nie stoi między moim Makiem a lokalnym wykryciem tak, jak krawędź stoi między moimi stronami a skanerem. Lista blokad może zatrzymać adres; nic poza Makiem nie zatrzyma procesu działającego na nim. Koszt tej reguły widać w sekcji 7.
W dniu, w którym reguły weszły w życie, ograniczyły strumień poczty z 74 e-maili przed 13:32 do siedmiu zalogowanych w pozostałej części dnia (sześć krytycznych i jeden alert godzinowy), plus digest wysłany przeze mnie ręcznie.52 Prognoza, którą napisałem tamtego popołudnia, mówiła „Under today’s traffic that would have been 0 immediate emails instead of 16.” (przy dzisiejszym ruchu dałoby to 0 natychmiastowych e-maili zamiast 16).1 Nie sprawdziła się, a sekcja 6 wyjaśnia dlaczego.
5. Przypadek testowy: 2 listopada, od 11:03 do 11:21
Pierwszy prawdziwy test reguł przyszedł następnego ranka: jeden adres należący do holenderskiego dostawcy hostingu przepuścił skaner podatności przez moją stronę.12 Oto, co zapisał monitor, dosłownie z jego logu w lokalnym czasie pacyficznym, z adresem zastąpionym przez „[the address]” i pominiętymi wierszami pośrednimi.4
[2026-11-02 11:03:53] [INFO] New finding [critical]: Request flood from [the address] on blakecrosley.com
[2026-11-02 11:04:02] [RESPOND] [INFO] Block notification: Slack posted, email folded into the daily digest
[2026-11-02 11:04:03] [INFO] Critical alert folded into the daily digest (IP on the block ledger): Request flood from [the address] on blakecrosley.com
[2026-11-02 11:04:04] [INFO] New finding [critical]: Scanner from [the address] on blakecrosley.com
[2026-11-02 11:04:05] [RESPOND] [INFO] Skip: [the address] already has active real block in blakecrosley.com (dedup)
[2026-11-02 11:04:05] [INFO] Critical alert folded into the daily digest (IP on the block ledger): Scanner from [the address] on blakecrosley.com
[2026-11-02 11:09:22] [INFO] New finding [critical]: 726 WAF blocks in 5 minutes
[2026-11-02 11:09:23] [INFO] Critical alert folded into the daily digest (IP on the block ledger): 726 WAF blocks in 5 minutes
[2026-11-02 11:09:44] [INFO] New finding [critical]: Persistent scanner: [the address] blocked 743 times today
[2026-11-02 11:09:47] [RESPOND] [INFO] Block notification: Slack posted, email folded into the daily digest
[2026-11-02 11:09:47] [INFO] Critical alert folded into the daily digest (IP on the block ledger): Persistent scanner: [the address] blocked 743 times today
Minuta po minucie:
- 11:03:53. Detektor fali żądań zgłasza alert krytyczny wobec adresu. Osiem sekund później, o 11:04:01, responder dodaje go do listy blokad, a o 11:04:02 powiadomienie o blokadzie trafia na czat, z e-mailem włączonym do digestu.4
- 11:04:03. Sam alert krytyczny trafia do digestu: adres jest już w rejestrze blokad, więc krawędź już wykonuje pracę, o którą prosiłby mnie e-mail.4
- 11:04:04. Drugi detektor, kontrola skanerów, zgłasza własny alert krytyczny dla tego samego adresu. Żądanie blokady od respondera zostaje pominięte jako duplikat, a alert trafia do digestu sekundę później.4
- 11:09:22. Detektor fali zdarzeń WAF zgłasza trzeci alert krytyczny dla strefy. Jego sprawca jest w rejestrze, więc alert trafia do digestu.411 Rozstrzyga o tym wyłącznie warunek listy blokad: osiem zdarzeń z próbki nie miało zapisanej blokady ani wyzwania, a próbka była przycięta do limitu, więc sam warunek WAF wysłałby ten alert e-mailem.11
- 11:09:44. Kontrola uporczywego skanera, która liczy zdarzenia zablokowane lub poddane wyzwaniu przez krawędź dla jednego adresu we wszystkich moich strefach, zgłasza czwarty alert, zapisany przy innej z moich stron: 743 zablokowane lub poddane wyzwaniu zdarzenia z tego adresu tego dnia.12 Responder po raz drugi wpisuje adres na listę (to defekt, o czym niżej), publikuje na czacie i o 11:09:47 włącza alert do digestu.411
- 11:14:58 i 11:20:40. Dwa kolejne alerty krytyczne o fali zdarzeń WAF dla tej samej strefy; oba trafiają do digestu w ten sam sposób.11
Cztery alerty krytyczne w 5 minut i 51 sekund, sześć do 11:20, wszystkie zapisane w swoich zgłoszeniach jako włączone do digestu, bo adres był zablokowany.11 Jeden zablokowany adres, z wpisem na liście zapisanym dwukrotnie, bo kontrola duplikatów działała wtedy w obrębie strony (poprawione 3 listopada), i cztery kolejne żądania blokady pominięte jako duplikaty.414 E-maile: zero. Log nie odnotowuje żadnego wysłanego e-maila między 11:03 a 11:21; jedyny alert krytyczny w tym oknie, który ani nie trafił do digestu, ani nie poszedł e-mailem, wyciszony o 11:03:13, dotyczył fali na innej stronie z innego adresu.4
Następny digest pokazał to jako dwa wiersze w tabeli automatycznych blokad (pierwsza blokada ze strefą, powodem i operatorem sieci oraz ponowne dodanie przez kontrolę uporczywego skanera) i sześć wierszy w tabeli wszystkich alertów krytycznych, każdy oznaczony „blocked” (zablokowany) lub „blocked earlier” (zablokowany wcześniej).12 W mojej ocenie to właściwa waga dla skanera, którego monitor zablokował osiem sekund po pierwszym wykryciu i osiem minut po rozpoczęciu skanowania: kilka wierszy do przeczytania przy kawie, a nie wezwanie.4
Jednej rzeczy przypadek testowy nie pokazuje; odkryłem ją 3 listopada. Ten sam skaner wysyłał też wiadomości przez formularz kontaktowy mojej strony, na które moja aplikacja odpowiadała kodem 200, co daje najwyżej 31 własnych e-maili; są one tematem wpisu towarzyszącego, a kontrola fali formularzy w monitorze nie zgłosiła na żywo żadnego wykrycia; odtworzona na kompletnych danych dla pięciu minut do 11:03:23, ta sama kontrola zgłasza wykrycie, z ważnością wysoką (wiersz w digeście, nie e-mail ani blokada), na podstawie 39 wysyłek, z których 23 odrzucono.39 Przebieg na żywo poprosił Cloudflare o okno kończące się w chwili zapytania, 37 sekund po starcie przebiegu, zanim najnowsze zdarzenia w pełni dotarły: naliczył w tym oknie 1914 żądań z tego adresu, podczas gdy odtworzenie na kompletnych danych liczy 2143.439 To opóźnienie zmierzono na wszystkich żądaniach z tego adresu, nie na wysyłkach formularza, które liczy kontrola; w mojej ocenie to samo opóźnienie utrzymało te wysyłki poniżej progu kontroli na żywo. Do tego każdy przebieg patrzył wstecz dokładnie pięć minut, a przebiegi startowały co około 5,6 do 5,8 minuty, więc część każdego interwału nigdy nie była skanowana.3917 Poprawka weszła tego samego dnia: każde okno zaczyna się teraz tam, gdzie skończyło się poprzednie, i kończy 90 sekund przed przebiegiem, chyba że poprzedniego zapisu brakuje, ma mniej niż minutę albo ponad 15 minut, jak po uśpieniu Maca; wtedy przebieg wraca do zwykłego spojrzenia pięć minut wstecz.39 Odtworzenie okna z 2 listopada przez zmieniony kod daje te same wykrycia, więc zmiana nie naruszyła detekcji w ustalonym oknie. Odtworzenie nie może przetestować dzielenia czasu na przylegające okna ani opóźnienia, które działają tylko w przebiegach na żywo; ich testem są przebiegi na żywo od 3 listopada.39
6. Co nadal idzie e-mailem i dlaczego
2 listopada był pierwszym pełnym dniem pod nowymi regułami i przyniósł 19 e-maili, a nie jeden: 14 krytycznych, jeden godzinowy alert o wolumenie, jeden digest i trzy od lokalnego skanera.5 Nie wyszedł żaden e-mail o blokadzie; zamiast tego 108 powiadomień o blokadach trafiło do digestu, tak samo 177 alertów krytycznych, a kolejne 37 wyciszył limit dwugodzinny, wszystko liczone według dnia lokalnego; liczby rezultatów podane dalej w tym wpisie idą według daty UTC i dlatego te wartości się różnią.5
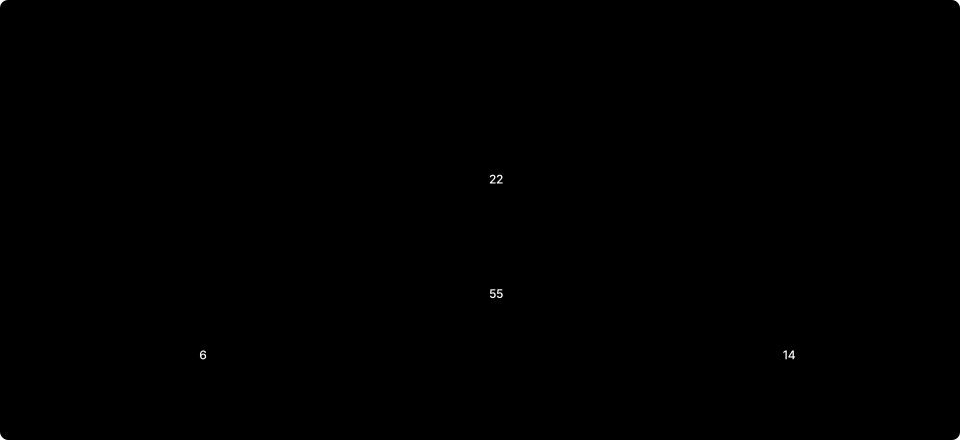
E-maile na dzień lokalny według strumienia; 31 października obejmuje tylko 89 minut od początku logu.5
Każdy alert krytyczny z chmury wysłany e-mailem od zmiany z 13:50 do końca 2 listopada, łącznie 20 (sześć w pozostałej części 1 listopada, czternaście 2 listopada), dotyczył fali zdarzeń WAF na resumegeni.com lub blakecrosley.com, w której co najmniej jedno zdarzenie nie miało zapisanej blokady ani wyzwania.13 Warunek WAF odrzucił każdy z nich poprawnie według własnej reguły: w próbce było zdarzenie niezneutralizowane, więc monitor nie mógł stwierdzić, że krawędź je obsłużyła.3 W tych falach żaden adres nie miał dość zdarzeń, by kwalifikować się do automatycznej blokady, więc warunek listy blokad nie miał żadnego adresu do sprawdzenia.13 Digest nazywa tę grupę tak samo: „a CRITICAL that was neither blocked nor already handled by the WAF” (CRITICAL, który nie został zablokowany ani nie był już obsłużony przez WAF).12
Tematy tych e-maili opowiadały inną historię, i to był defekt. Podsumowanie fali brzmiało „N WAF blocks in 5 minutes” (N blokad WAF w 5 minut), ale N liczyło każde zdarzenie firewalla nie od bota w oknie, bez względu na akcję podjętą przez krawędź.13 Dwa przykłady ze zgłoszeń, w czasie lokalnym:
| Kiedy (PT) | Strona | Temat mówił | Zablokowane | Z wyzwaniem | Niezneutralizowane |
|---|---|---|---|---|---|
| 1 lis, 16:51 | blakecrosley.com | „104 WAF blocks in 5 minutes” | 0 | 0 | 117 ze 117 zdarzeń |
| 1 lis, 22:45 | resumegeni.com | „108 WAF blocks in 5 minutes” | 18 | 62 | 99 ze 179 zdarzeń |
Pierwszy e-mail twierdził, że było 104 blokady, gdy krawędź nie zablokowała niczego.13 W mojej ocenie temat mówiący o „blokadach” przy zdarzeniach bez zapisanej blokady jest gorszy niż szum: mówi jedynemu czytelnikowi, że system obsłużył coś, czego mógł nie obsłużyć. Moja pierwsza poprawka, 3 listopada, w dniu, w którym zrobiłem te zliczenia, sama była błędna. Zachowywała liczbę zdarzeń nie od botów jako N, a zablokowane, poddane wyzwaniu i resztę liczyła po wszystkich zdarzeniach, więc seria z 16:51 brzmiałaby 104 WAF events in 5 minutes: 0 blocked, 0 challenged, 117 through, czyli dwie populacje w jednym wierszu. Wychwyciła to recenzja tego wpisu, a ja poprawiłem to ponownie tego samego dnia.14 Podsumowanie fali, a wraz z nim temat e-maila, liczy teraz jedną populację, każde zdarzenie firewalla z próbki, i brzmi N WAF events in 5 minutes: B blocked, C challenged, U unmitigated (S from non-bot user agents); wyzwanie JavaScript liczy się jako wyzwanie, a powód automatycznej blokady brzmi N WAF events from this address in 5 min.14 Dla serii z 16:51 daje to 117 WAF events in 5 minutes: 0 blocked, 0 challenged, 117 unmitigated (104 from non-bot user agents).1314 Warunek WAF już wcześniej opierał się na zdarzeniach niezneutralizowanych, więc temat i decyzja liczą teraz to samo. Poprawka zmienia treść tych 14 tematów. Nie zmienia liczby wysłanych e-maili, a 19 pozostaje uczciwą liczbą dla 2 listopada.
Prognoza, którą napisałem 1 listopada, chybiła, bo jej przesłanka była błędna. Mówiła, że nowe reguły „would have been 0 immediate emails instead of 16” (dałyby 0 natychmiastowych e-maili zamiast 16), w przekonaniu, że w przypadku siedmiu alertów krytycznych po 00:30 tamtego ranka „Cloudflare had already blocked every one of those requests.” (Cloudflare już zablokował każde z tych żądań).1 Zgłoszenia mówią co innego również o nich: pięć, które log pokazuje jako wysłane e-mailem po 00:30, odnotowuje najwyżej jedną blokadę i dziewięć wyzwań każde, wobec od 76 do 89 zdarzeń w ich podsumowaniach.13 A w każdym z sześciu alertów krytycznych, które poszły e-mailem tamtego popołudnia i wieczoru, krawędź zablokowała lub poddała wyzwaniu tylko część zdarzeń (w serii z 16:51 żadnego), więc nawet reguła z 13:50, która włączała do digestu tylko wtedy, gdy blokady i wyzwania obejmowały każde zdarzenie nie od bota, wysłałaby e-mailem każdy z nich.131 Dziesięć minut po zmianie z 13:50 druga zmiana sprawiła, że warunek WAF liczy każde zdarzenie, od bota czy nie, i ufa tylko kompletnej próbce; zaostrzyła regułę, ale to nie przez nią prognoza chybiła.183 Prognoza liczyła blokady, w które wierzyłem; reguła liczyła zdarzenia, które faktycznie były.
Nie wiem natomiast, czy te 14, czyli alerty krytyczne z 2 listopada, które poszły e-mailem, zasługiwały na e-mail. Zgłoszenia zapisują, ile zdarzeń pozostało niezneutralizowanych, czyli bez zapisanej blokady lub wyzwania, ale nie to, jakie akcje im towarzyszyły: reguła log, skip, allow czy wyzwanie rozwiązane przez klienta.13 Zdarzenie niezneutralizowane nie jest też żądaniem, które dotarło do mojej strony. Cloudflare pisze, że „A single HTTP request can generate one or more security events when it triggers security features” (jedno żądanie HTTP może wygenerować jedno lub więcej zdarzeń bezpieczeństwa, gdy uruchamia funkcje bezpieczeństwa), i wymienia log oraz skip jako akcje, które nie kończą ewaluacji reguł tak jak blokada, więc w mojej ocenie inna reguła może jeszcze zadziałać na to samo żądanie.2436 Samouczek GraphQL od Cloudflare pokazuje pole action i przykładowe wartości, takie jak "log" i "block", ale nie wymienia wszystkich wartości, jakie pole może przyjąć.23 Panel Security Events w Cloudflare również próbkuje: „For large volumes of traffic, Cloudflare uses sampling to return results faster.” (przy dużym wolumenie ruchu Cloudflare stosuje próbkowanie, by szybciej zwracać wyniki).24 Dopóki monitor nie zapisuje akcji stojących za każdym niezneutralizowanym zdarzeniem i nie wiąże zdarzeń z żądaniami, nie potrafię powiedzieć, które z tych e-maili opisywały ruch przepuszczony przez krawędź, a od tej odpowiedzi zależy, czy zasługują na e-mail.
Trzy lokalne e-maile z 2 listopada to druga otwarta sprawa. Zgłaszają „Browser -> shell chain” (łańcuch od przeglądarki do powłoki) o 13:50, w którym powłoka uruchomiła curl, i pozostają nierozwiązane w zgłoszeniach.40 Nie sprawdziłem, czy było to narzędzie agentowe, którego używałem tamtego popołudnia, czy coś innego, więc nie liczę ich jako fałszywych alarmów.
7. Dwa fałszywe sygnały
Koparka kryptowalut, która okazała się Spotlightem
1 listopada o 10:03 lokalny skaner zgłosił alert krytyczny „High CPU unsigned process - possible crypto miner” (niepodpisany proces z wysokim użyciem CPU, możliwa koparka kryptowalut) wobec spotlightknowledged, własnego demona Spotlight od Apple, przy 74,9 procent CPU, a dwie sekundy później zalogował „Critical email sent”.15 Błąd był mój. Kontrola szukała frazy „valid on disk” w wyjściu polecenia wyświetlającego podpis kodu, codesign -d. Notatki skanera zapisują teraz wadę w jednym zdaniu podrzędnym: ta fraza to taka, „which only codesign -v prints, so every process read as unsigned” (którą wypisuje tylko codesign -v, więc każdy proces odczytywano jako niepodpisany).25 Lista pominięć ukrywała tę wadę, dopóki nie skoczyło obciążenie demona jednego z frameworków Apple, co odnotowuje mój log z tamtego dnia.1 Zgłoszenie ma teraz zapisane rozstrzygnięcie: „false positive, Apple platform binary” (fałszywy alarm, binarium platformy Apple).41
Kosztowało to jeden e-mail, jedyny lokalny e-mail z 1 listopada.5 Wcześniejsze 16 lokalnych alertów krytycznych, z 31 października i 1 listopada, oznaczało Xcode, Pythona z Homebrew, moje własne buildy aplikacji, zmiany w hookach, shimy menedżerów wersji w ścieżce, wzorzec robaka AI dopasowany do instrukcji agenta z innego projektu i kontrolę event tapów, która dopasowała własne zapytanie; dały 15 prób wysyłki i każda się nie powiodła.5251915 Usługa pocztowa stoi za Cloudflare, który na domyślny user agent Pythona odpowiadał błędem 1010, zanim w ogóle odczytano klucz; odtworzyłem to z celowo błędnym kluczem.19 Strona Cloudflare o tym błędzie wprost wymienia tego klienta, w uwadze o hostach Pages i Workers: „a User-Agent header that Browser Integrity Check treats as a non-browser client (for example, the default Python urllib user agent).” (nagłówek User-Agent, który Browser Integrity Check traktuje jako klienta niebędącego przeglądarką, na przykład domyślny user agent urllib w Pythonie).42 Zepsuty nadawca oszczędził mi 15 e-maili o moich własnych narzędziach i moich własnych zmianach.15 Notatki skanera formułują szerszą lekcję wprost: „most of the CRITICALs it raised in its first live days were its own noise.” (większość CRITICAL zgłoszonych w pierwszych dniach pracy na żywo była jego własnym szumem).25 Mimo to utrzymuję lokalne alerty krytyczne jako natychmiastowe i każdy fałszywy poprawiam w samej kontroli, zamiast wyciszać strumień.
RUNS SHORT 162/207
Pierwszy zaplanowany digest, rano 2 listopada, miał temat „Mon Nov 2: 71 blocks on 15 zones, 11 criticals emailed, RUNS SHORT 162/207” (pon. 2 lis.: 71 blokad w 15 strefach, 11 alertów krytycznych wysłanych e-mailem, za mało przebiegów 162/207).16 Reguła digestu była prostą arytmetyką: oczekiwana liczba przebiegów to liczba minut okna podzielona przez pięć, a temat sygnalizuje niedobór.35 Okno trwało od 13:48 1 listopada do 07:05 2 listopada, 1036,5 minuty, czyli 207 pięciominutowych slotów; log zapisał 162 przebiegi.17
Mój log z 2 listopada wyjaśnił lukę jednym zdaniem: „The RUNS SHORT line is the Mac asleep” (wiersz RUNS SHORT to uśpiony Mac), bez usterki w monitorze.43 To zdanie ma rację, że monitor nie zawiódł (żaden przebieg 2 listopada nie został niedokończony), i myli się co do przyczyny, zarówno 2 listopada, jak i w oknie, które opisywała liczba. Analiza luk między przebiegami dzieli 45 brakujących slotów, w przybliżeniu, na około 25 straconych przez rytm uruchomień, około 16 przez uśpienie, mniej więcej jeden więcej w długiej luce po przebiegu, który zakończył się przedwcześnie, oraz trzy przebiegi, które nigdy się nie zarejestrowały.17
| Przyczyna | Sloty, w przybliżeniu | Dowody |
|---|---|---|
| Rzeczywisty rytm uruchomień | 25 | 160 zwykłych luk między przebiegami, mediana 5,60 minuty, nigdy poniżej 5,35; wypełniają 926,0 minuty, 185 pięciominutowych slotów |
| Uśpienie | 16 | trzy luki ponad 10 minut, łącznie 93,0 minuty, w okresach uśpienia z bezczynności według dziennika zasilania, z przebiegami wznawianymi podczas krótkich wybudzeń konserwacyjnych |
| Długa luka po przedwczesnym zatrzymaniu | 1 | czwarta luka ponad 10 minut, 10,0 minuty po przebiegu z 14:19, który zakończył się przedwcześnie |
| Przebiegi, które nigdy się nie zarejestrowały | 3 | 165 startów przebiegów wobec 162 zarejestrowanych przebiegów |
| Za tymi trzema | trzy przebiegi zakończyły się około czterech minut po starcie bez zalogowanego wiersza końcowego, sądząc po czasach przez 240-sekundowy watchdog, wszystkie 1 listopada: dwa po południu i jeden późnym wieczorem |
Dziennik zasilania pokazuje uśpienie z bezczynności o 23:21:30 i pełne wybudzenie o 00:30:05, a potem znów uśpienie z bezczynności o 06:01:20 i pełne wybudzenie o 06:30:28.44 Trzy przebiegi wystartowały 1 listopada o 14:09, 14:19 i 23:10; każdy zakończył się około czterech minut później bez zalogowanego wiersza końcowego, co w mojej ocenie oznacza 240-sekundowy watchdog (proces nadzorczy, który zabija zawieszone przebiegi). Czwarty przebieg zakończył się 28 sekund po starcie bez widocznej przyczyny.1738 W dniu kalendarzowym 2 listopada wystartowały 242 przebiegi wobec 288 pięciominutowych slotów, czyli o 46 za mało, i żaden nie został niedokończony; tylko dwie luki przekroczyły 10 minut, łącznie 35,8 minuty, więc także tego dnia większość niedoboru wynikała z rytmu uruchomień, a nie z uśpienia.17
Błędne założenie było moje, w digeście: harmonogram ustawiony na pięć minut dawał przebieg mniej więcej co 5,6 do 5,8 minuty nawet wtedy, gdy Mac nie spał, więc pięciominutowa arytmetyka uznałaby zdrowy dzień za niedoborowy.17 Nie ustaliłem, dlaczego rytm w stanie czuwania jest wolniejszy. 3 listopada zastąpiłem tę arytmetykę. Stan przebiegów podaje teraz zarejestrowane przebiegi, medianę minut między nimi i najdłuższą lukę wraz z godziną, a temat sygnalizuje wyłącznie lukę dłuższą niż 20 minut. Podgląd z tamtego ranka mówił „about one every 5.6 min” (mniej więcej jeden co 5,6 min), a jego temat kończył się na „RUN GAP 31 min at 05:56” (luka 31 min o 05:56).14 Luka to objaw, na który mogę zareagować: Mac zasnął albo monitor stanął. Stosunek liczony względem rytmu, którego harmonogram nigdy nie dostarczył, nie był ani jednym, ani drugim.
Reguły, które zachowałem
- Należy policzyć pocztę, zanim się ją zmieni: według strumienia i według jawnie zapisanej reguły. Moja tabela i zliczenie z logu zgodziły się co do 74 tylko dlatego, że najpierw zapisałem, co liczy się jako e-mail.12
- „sent” warto logować tylko wtedy, gdy usługa pocztowa odpowie twierdząco. Dla 22 z moich 74 e-maili mogę udowodnić próbę i nic więcej.26
- Blokada, którą krawędź już założyła, to wiersz logu, a nie alert. Tam umieszczają ją trzy rodzaje wyjścia z książki o SRE, a przeniesienie 55 e-maili o blokadach na czat nie odebrało mi niczego, na co bym zareagował.75
- Dzienny digest trzeba wysyłać nawet wtedy, gdy nic się nie wydarzyło. Digest, który zawsze przychodzi, jest sygnałem życia; jego brak jest alertem.35
- Alert krytyczny można włączyć do digestu tylko pod warunkiem, który krawędź potwierdza. U mnie są to: adresy ze zgłoszenia kwalifikujące się do blokady już obecne na liście blokad oraz kompletna próbka, w której każde zdarzenie ma zapisaną blokadę lub wyzwanie; ten drugi warunek jest powodem, dla którego 2 listopada 14 alertów nadal poszło e-mailem.313
- Rezultat należy zapisywać przy każdym alercie krytycznym z chmury. Dzienny raport, za który nikt nie odpowiada, to według słów Ewaschuka „less-spammy email alerts” (nieco mniej spamerskie alerty e-mailowe); rezultat w każdym wierszu jest tym, co sprawdza moja codzienna segregacja.3012
- Temat powinien mówić, co zrobiła krawędź. „104 WAF blocks” przy serii z zerem blokad było moim najgorszym wierszem tygodnia.13
- Raportować luki, a nie stosunki względem harmonogramu. Pięciominutowy timer dawał przebieg mniej więcej co 5,6 minuty, więc 162/207 wyglądało na awarię, a było głównie zegarem.17
- Fałszywy alarm naprawia się w kontroli, a nie w skrzynce. Jedno źle odczytane wyjście polecenia zrobiło z demona Spotlight od Apple koparkę kryptowalut; poprawka trafiła do kontroli.25
Co mogłoby to zmienić
- Jeśli zdarzenia niezneutralizowane okażą się rozwiązanymi wyzwaniami, samo to nie uczyni szumem krytycznych alertów o fali zdarzeń WAF, które wciąż idą e-mailem. Gdy klient przejdzie wyzwanie, „Cloudflare accepts the matched request” (Cloudflare przyjmuje dopasowane żądanie): żądanie idzie dalej, a to nie dowodzi, że było nieszkodliwe ani że nic nie wymaga reakcji. Włączenie tych alertów do digestu wymagałoby dowodów na poziomie żądań, powiązanych z tymi samymi zdarzeniami, pokazujących, że nic w nich nie potrzebowało człowieka, a samo przejście wyzwania takim dowodem nie jest. Jeśli okażą się regułami
loglubskip, pytanie brzmi, czy te reguły robią to, co zamierzałem, i każdy e-mail jest wart przeczytania, dopóki tego nie wiem. Monitor jeszcze nie zapisuje, który przypadek zachodzi.1336 - Jeśli dzienna liczba e-maili krytycznych znów zbliży się do kilkudziesięciu, to dwugodzinny limit na stronę i kategorię wykonuje pracę, którą powinna wykonywać reguła, i regule trzeba się przyjrzeć ponownie.3
- Jeśli digest przestanie przychodzić, coś między monitorem a moją skrzynką stanęło: monitor, Mac, na którym działa, nadawca albo ścieżka doręczenia, bo przyjęta wysyłka to jeszcze nie doręczona wiadomość. To jedyna cisza, którą projekt traktuje jako sygnał, żeby sprawdzić.3520
- Jeśli lokalny skaner zgłosi alert krytyczny, którego nie potrafię wyjaśnić własnymi narzędziami, natychmiastowy e-mail był słuszną decyzją; trzy nierozwiązane zgłoszenia łańcucha powłoki z 2 listopada to otwarty test tej tezy.40
- Jeśli dołączy drugi czytelnik, wezwania i tickety przestaną trafiać do tej samej osoby, a podział na alerty i tickety z książki o SRE będzie wymagał kolejki ticketów, nie mojej skrzynki.7
Najważniejsze wnioski
Dla osób prowadzących monitor na własny użytek
- Przestałem czytać gdzieś przed 74 e-mailami w pół dnia, a moja skrzynka doszła do tej liczby wczesnym popołudniem.1
- Dzienny digest, który przychodzi także w spokojne dni, to darmowy sygnał życia; monitor, który odzywa się tylko przy zdarzeniach, nie powie, że umarł.35
- Logi mogą twierdzić „sent” o poczcie, która nigdy nie wyszła. Warto sprawdzić kod, zanim zaufa się liczbie.619
Dla osób, które go budują
- Najpierw działać, potem decydować, czy powiadomić: zablokować, a następnie włączyć alert do digestu, jeśli lista blokad lub krawędź już go obejmują.3
- Zapisywać rezultat każdego alertu krytycznego przy zgłoszeniu i drukować go w digeście, żeby osoba, która według Ewaschuka musi segregować dzienny raport, miała co sprawdzać; w moim monitorze tą osobą jestem ja.3012
- Nazywać zdarzenia według tego, co krawędź dla nich zapisała (zablokowane, poddane wyzwaniu, niezneutralizowane), liczyć jedną populację w jednym wierszu i nigdy nie nazywać ich według tego, co krawędź miała zrobić w naszych nadziejach.1314
- Mierzyć harmonogram, który faktycznie się ma. Mój uruchamiał się co 5,6 minuty przy pięciominutowym timerze.17
Dla osoby, która czyta skrzynkę
- O każdy alert warto zapytać, czy jest „urgent, important, actionable, and real” (pilny, ważny, wymagający działania i prawdziwy); wszystko, co nie przechodzi tego testu, należy do digestu lub logu.29
- Moja prognoza z pierwszego dnia chybiła: mówiła o zerze natychmiastowych alertów krytycznych, a następny dzień przyniósł 14.15
Często zadawane pytania
Czym jest zmęczenie alertami?
Zmęczenie alertami to to, co dzieje się z ludźmi, którzy dostają zbyt wiele alarmów niewymagających od nich niczego: stają się, słowami The Joint Commission, „desensitized or immune to the sounds” (znieczuleni lub odporni na dźwięki) i zaczynają ściszać albo wyłączać alarmy.10 Książka Google o SRE opisuje to samo w operacjach, gdzie ludzie „second-guess, skim, or even ignore incoming alerts, sometimes even ignoring a “real” page that’s masked by the noise.” (powątpiewają, przeglądają pobieżnie albo wręcz ignorują przychodzące alerty, czasem nawet „prawdziwe” wezwanie ukryte w szumie).27 W moim przypadku zajęło to jeden dzień: 74 e-maile do 13:32, z których żaden, w mojej ocenie z tamtego popołudnia, nie prosił mnie o działanie.1
Ile alertów bezpieczeństwa dziennie to za dużo?
Dla jednej osoby uczciwa odpowiedź rozdziału o SRE brzmi: kilka. „I can only react with a sense of urgency a few times a day before I become fatigued.” (z poczuciem pilności mogę zareagować tylko kilka razy dziennie, zanim się zmęczę).8 Ankieta dostawcy, Vectry, podaje, że zespoły otrzymują średnio 4484 alerty dziennie i, według własnych deklaracji, ignorują 67 procent z nich.34 Dla mojego jednoosobowego monitora robocza odpowiedź to jeden digest dziennie plus alerty, które potrzebują człowieka teraz; 2 listopada dało to nadal 19, a 14 krytycznych alertów o fali zdarzeń WAF wśród nich traktuję jako otwarte pytanie, a nie zaakceptowany koszt.513
Alerty bezpieczeństwa w dziennym digeście czy w czasie rzeczywistym?
Jedno i drugie, z podziałem według tego, co musi zrobić człowiek. Wszystko, co monitor uznaje za już obsłużone (adres, który wpisał na listę blokad, albo fala, w której każde zdarzenie z próbki zostało zablokowane lub poddane wyzwaniu), trafia do digestu; reszta idzie od razu, w ramach dwugodzinnego limitu.3 Ewaschuk dopuszcza, że dzienny raport „can work too” (też może się sprawdzić), z jednym warunkiem: bez odpowiedzialności „amounts to less-spammy email alerts” (sprowadza się do nieco mniej spamerskich alertów e-mailowych), a on chce kogoś „designated to triage these every day” (wyznaczonego do codziennego segregowania tych raportów).30 W moim monitorze to ja, a mój digest drukuje los każdego alertu krytycznego z chmury, żeby segregacja miała co sprawdzać.12
Czym jest alert typu heartbeat?
Heartbeat, czyli sygnał życia, to wiadomość, która przychodzi według harmonogramu niezależnie od tego, czy coś się wydarzyło, tak by jej brak oznaczał, że coś się zepsuło. Moim sygnałem życia jest dzienny digest: „it goes out on a quiet day too” (wychodzi również w spokojny dzień), więc monitor, który przestał działać, objawia się brakującym e-mailem.35 Tak samo objawia się nieudana wysyłka lub zgubione doręczenie, więc brakujący digest to sygnał, żeby sprawdzić monitor, hosta, na którym działa, nadawcę i ścieżkę doręczenia.20 Jego sekcja o stanie przebiegów podaje też najdłuższą lukę między przebiegami i oznacza w temacie lukę dłuższą niż 20 minut.14
Dlaczego alerty Cloudflare WAF zalewają moją skrzynkę?
Moja skrzynka była zalewana, bo każda blokada i każdy alert krytyczny stawały się osobną wiadomością, a internet skanuje każdą publiczną strefę przez cały dzień.5 Własne alerty Cloudflare, „Monitors that you define yourself, and Platform Notifications” (monitory definiowane samodzielnie i powiadomienia platformy), można dostarczać e-mailem i konfiguruje się je w panelu; monitor zbudowany samodzielnie na ich API, taki jak mój, nie jest żadnym z nich i dziedziczy każdą wysyłkę per zdarzenie, którą się w niego wpisze.26 Warto też sprawdzić, co alert liczy: wśród akcji Cloudflare są log i skip, które nie kończą ewaluacji reguł tak jak blokada, a wyzwanie rozwiązane przez klienta kończy się przyjęciem żądania przez Cloudflare, więc „zdarzenia WAF” i „blokady WAF” to różne liczby.36 Moje tematy myliły jedno z drugim aż do 3 listopada.1314
Czy odpowiedź 2xx z API pocztowego oznacza, że alert został doręczony?
Nie. Zdarzenie email.sent w Resend „Occurs whenever the API request was successful. Resend will attempt to deliver the message to the recipient’s mail server” (występuje, gdy żądanie do API się powiodło; Resend spróbuje doręczyć wiadomość na serwer pocztowy odbiorcy), a doręczenie to osobne zdarzenie.20 2xx oznacza, że usługa przyjęła wiadomość. Należy logować kod statusu, a doręczenie traktować jako osobne pytanie.6
Powiązane na tej stronie: Dlaczego spam pokonał mój formularz kontaktowy z limitem żądań śledzi tego samego skanera z 2 listopada od strony formularza kontaktowego; Co uruchamiam przed snem to nocna kontrola produkcji, druga rutyna działająca, gdy nie patrzę; Co naprawdę się psuje, gdy agenci AI działają bez nadzoru wymienia tryby awarii sesji agentów pozostawionych bez opieki, każdy z sygnałem wykrycia; Każdy hook to blizna prowadzi każdy z moich hooków agentowych do awarii, która go zrodziła, czyli ten sam nawyk co naprawianie fałszywego alarmu w jego kontroli; Tryb auto w Claude Code nie jest granicą bezpieczeństwa dowodzi, że mur wokół agenta znaczy więcej niż jego klasyfikator; a Obserwowalność agentów AI przekonuje, że trzeba widzieć, co agenci robią z dyskiem, procesorem i siecią.
Źródła
Wszystkie godziny w danych autora to lokalny czas pacyficzny, chyba że oznaczono UTC; 1 listopada o 02:00 nastąpiła zmiana z PDT na PST. Strony publiczne pobrano 3 listopada 2026 o podanych godzinach UTC.
-
Dziennik operacyjny autora (Captain’s Log) z 1 listopada 2026: wiadomość z 13:32 PT; tabela 74 e-maili od północy według strumienia (55 o blokadach, 16 krytycznych, 2 godzinowe o wolumenie, 1 lokalny); reguła włączania do digestu z 13:50 (blokady i wyzwania obejmujące każde zdarzenie nie od bota); podział alertów krytycznych jako „9 before the fold went live at 00:30 PT; the 7 after” wraz z przekonaniem, że „Cloudflare had already blocked every one of those requests”; „Yesterday had 10”; pierwszy digest wysłany ręcznie o 13:48 PT; prognoza „Under today’s traffic that would have been 0 immediate emails instead of 16”; oraz uwaga, że lista pominięć ukryła błąd w kontroli podpisu kodu. ↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩
-
Dane autora: liczba e-maili wyprowadzona skryptem z logów monitora, ucięta 1 listopada o 13:32 PT: 74 (55 o blokadach, 16 krytycznych, 2 godzinowe o wolumenie, 1 lokalny), z czego 22 (10 o blokadach, 11 krytycznych, 1 godzinowy) pochodziły od nadawców, którzy logowali „sent” bezwarunkowo; 81 dla całego lokalnego dnia. Lista wierszy z tego samego skryptu umieszcza 11 krytycznych wierszy „sent” przed 00:30 i 5 po, a pierwszy alert krytyczny włączony do powiadomienia o blokadzie o 00:54:43. ↩↩↩↩↩↩↩↩↩
-
Notatki projektowe autora dla monitora, sekcja powiadomień, stan na 3 listopada 2026: „Every one described routine mass-scanning the edge had already stopped”; „Per block: Slack only”; dwa warunki włączania do digestu i ich kolejność; „A solved or bypassed challenge, log, allow and skip all count as unmitigated”; godzinowy alert o wolumenie utrzymany jako natychmiastowy; alerty krytyczne lokalnego skanera utrzymane jako natychmiastowe, bo z założenia mają być rzadkie. ↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩
-
Dane autora: log monitora z 2 listopada 2026, od 11:03 do 11:21 PT: wiersze przytoczone w sekcji 5 (adres zastąpiony), zapisy na liście blokad o 11:04:01 i 11:09:46 z siedmiodniowym wygaśnięciem, cztery pominięte zduplikowane żądania blokady, publikacje na czacie i brak wiersza e-mailowego w oknie poza wyciszoną falą na innej stronie o 11:03:13; przebieg, który zgłosił pierwszy alert krytyczny, wystartował o 11:02:46, a okno jego detektora skończyło się o 11:03:23, 37 sekund później, zaś powód blokady naliczył 1914 żądań z tego adresu w tym oknie. Pierwsze żądania skanu dotarły do strony o 10:56 PT, osiem minut przed blokadą (dziennik operacyjny autora z 2 listopada i minutowe liczniki żądań Cloudflare dla tego adresu). ↩↩↩↩↩↩↩↩↩↩↩↩↩
-
Dane autora: liczba e-maili wyprowadzona skryptem z sześciu logów monitora od 31 października do 2 listopada 2026 (część chmurowa i lokalny skaner), jeden e-mail na każdy wiersz zapisujący przekazanie wiadomości usłudze pocztowej. Według dnia lokalnego: 31 października (log zaczyna się o 22:31), 10 (4 o blokadach, 6 krytycznych, wszystkie od nadawców logujących „sent” bezwarunkowo; 3 alerty krytyczne wyciszone przez limit dwugodzinny; 13 nieudanych lokalnych wysyłek); 1 listopada, 81 zalogowanych (55 o blokadach, 22 krytyczne, 3 godzinowe o wolumenie, 1 lokalny; 2 nieudane lokalne wysyłki) plus jeden digest wysłany ręcznie; 2 listopada, 19 (14 krytycznych, 1 godzinowy o wolumenie, 1 digest, 3 lokalne). Niewysłane e-mailem 2 listopada: 108 powiadomień o blokadach i 177 alertów krytycznych włączonych do digestu, 37 alertów krytycznych wyciszonych. ↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩
-
Kod autora: nadawcy monitora w wersji uzbrojonej 31 października 2026, którzy odrzucali odpowiedź na żądanie pocztowe, a potem bezwarunkowo logowali „sent”, oraz zmiana z 1 listopada, 01:04 PDT, przed cofnięciem zegarów, po której nadawcy części chmurowej logują status HTTP usługi pocztowej i piszą „sent” tylko przy 2xx; nadawca lokalnego skanera zapisuje gołe „Critical email sent” i robi to tylko wtedy, gdy żądanie nie zgłosiło błędu. ↩↩↩↩↩↩
-
Benjamin Treynor Sloss, “Introduction,” rozdział 1 książki Site Reliability Engineering: How Google Runs Production Systems (Google, wyd. O’Reilly Media), pobrano o 14:19:33Z: trzy rodzaje prawidłowego wyjścia monitoringu (alerty, tickety, logowanie), cytowane, oraz fragment nazywający alertowanie typu „przeczytaj e-mail i zdecyduj” „fundamentally flawed” (z gruntu wadliwym). ↩↩↩↩↩↩
-
Rob Ewaschuk, “Monitoring Distributed Systems,” rozdział 6 książki Site Reliability Engineering (Google, O’Reilly Media), pobrano o 14:18:54Z: „Every page should be actionable”, zdanie o pilności i zdanie o mechanicznej reakcji, cytowane. ↩↩↩
-
Ewaschuk, “Monitoring Distributed Systems,” pobrano o 14:18:54Z: definicja alertu i przypis 22 o alertach e-mailowych („alert spam”), cytowane. ↩↩
-
The Joint Commission, “Medical device alarm safety in hospitals,” Sentinel Event Alert nr 50, 8 kwietnia 2013, czytane z kopii Wayback Machine z 13 listopada 2024, pobrano o 14:21:49Z (własny URL wydawcy odpowiedział 403): sygnały alarmowe na pacjenta dziennie; szacunek od 85 do 99 procent, który alert przypisuje AAMI i który obejmuje alarmy niewymagające interwencji klinicznej, bez wydzielania fałszywych; fragmenty o znieczuleniu i ściszaniu; 98 zdarzeń związanych z alarmami od stycznia 2009 do czerwca 2012, z czego 80 zakończyło się śmiercią; oraz „the most common contributing factor”, cytowane z listy czynników alertu wykraczających poza zgłoszone do jego bazy Sentinel Event, odrębnej od własnej listy zgłoszonych czynników tej bazy. ↩↩↩↩↩
-
Dane autora: sześć krytycznych zgłoszeń dotyczących skanera z 2 listopada w pliku zgłoszeń monitora (11:03:53 fala żądań, 11:04:04 skaner, 11:09:22 fala WAF, 11:09:44 uporczywy skaner, 11:14:58 i 11:20:40 fala WAF), każde zapisane jako włączone do digestu, bo adres był na liście blokad; fala WAF z 11:09:22 zapisuje też osiem zdarzeń z próbki bez zapisanej blokady lub wyzwania oraz liczbę zdarzeń firewalla równą limitowi próbki monitora, więc jej próbka była przycięta. ↩↩↩↩↩↩
-
Dane autora: następny digest w postaci wygenerowanej przez tryb podglądu programu digestu 3 listopada 2026 (okno od poniedziałku 2 listopada, 07:05, do wtorku 3 listopada, 06:17 PST; podgląd niczego nie wysyła): jego sekcje, 10-minutowe poziomy lokalnego skanera, lista blokad obejmująca całe konto egzekwowana w każdej strefie przez siedem dni, tabela automatycznych blokad z operatorem sieci (holenderski dostawca hostingu w przypadku skanera z 2 listopada), tekst nagłówka „Criticals that emailed you” i tabela „Every CRITICAL and what became of it”. ↩↩↩↩↩↩↩↩↩↩↩↩
-
Dane autora: każdy alert krytyczny zapisany jako wysłany e-mailem od zmiany z 13:50 PST 1 listopada, kiedy zaczyna się pole rezultatu, do końca 2 listopada PST, łącznie 20 (15 z datą 1 i 2 listopada UTC i pięć z datą 3 listopada UTC, wysłanych o 16:42, 17:58, 20:34, 21:07 i 23:08 PST), z pliku zgłoszeń wraz ze szczegółami, które o każdym zdecydowały: wszystkie to fale WAF na resumegeni.com lub blakecrosley.com ze zdarzeniami bez zapisanej blokady lub wyzwania; sześć z 1 listopada ze zdarzeniami nie od botów zablokowanymi lub poddanymi wyzwaniu przez krawędź (licznik acted w zgłoszeniach) poniżej liczby zdarzeń (5 z 83, 95 ze 153, 0 ze 104, 67 ze 128, 54 ze 135, 80 ze 108); dwa z 2 listopada bez żadnej blokady (05:55 PST, 26 z wyzwaniem; 12:06 PST, 204 z wyzwaniem); dla wszystkich 20 log monitora nie pokazuje żadnego pojedynczego adresu z liczbą zdarzeń wystarczającą do blokady; dwa wiersze ujęte w tabeli w sekcji 6 (2026-11-02T00:51:04Z i 06:45:59Z); tekst podsumowania liczący każde zdarzenie firewalla nie od bota jako „WAF block”; dla serii z 16:51 104 zdarzenia nie od botów i łącznie 117 zdarzeń, z których żadne nie zostało zablokowane ani poddane wyzwaniu; oraz, dla pięciu alertów krytycznych, które log pokazuje jako wysłane e-mailem między 00:30 a 13:32 PT 1 listopada, liczby zablokowanych i poddanych wyzwaniu ze zgłoszeń (0 i 0 wobec 79 zdarzeń, 0 i 9 wobec 81, 1 i 0 wobec 89, 1 i 9 wobec 84, 0 i 5 wobec 76); zgłoszenia nie zapisują, jakie akcje towarzyszyły tym zdarzeniom. ↩↩↩↩↩↩↩↩↩↩↩↩↩↩↩
-
Kod i dane autora, 3 listopada 2026: szablon podsumowania fali WAF w monitorze, najpierw przepisany tego ranka jako
N WAF events in 5 minutes: B blocked, C challenged, U throughz N jako liczbą zdarzeń nie od botów, a potem, po recenzji tego wpisu, jakoN WAF events in 5 minutes: B blocked, C challenged, U unmitigated (S from non-bot user agents)dla każdego zdarzenia z próbki, z wyzwaniami JavaScript liczonymi jako wyzwania; jego powód automatycznej blokadyN WAF events from this address in 5 min; rezultat „pending” zapisywany przy alercie krytycznym przed uruchomieniem automatycznej blokady, który digest drukuje jako przebieg przerwany przed zakończeniem ścieżki alertu; zbiór adresów dla warunku listy blokad (własny adres zgłoszenia i adresy kwalifikujące się do automatycznej blokady) i jego miejsce przed warunkiem WAF; kontrola duplikatów automatycznej blokady, która do tego dnia działała w obrębie strony i dlatego wpisała adres z 2 listopada na listę dwukrotnie, tego dnia zmieniona na kontrolę per adres (notatki projektowe monitora dla tej wersji i dziennik operacyjny z 3 listopada); reguła stanu przebiegów w digeście (zarejestrowane przebiegi, mediana minut między przebiegami, najdłuższa luka z godziną, oznaczenie w temacie tylko dla luki ponad 20 minut); oraz podgląd z tamtego ranka, który mówił „about one every 5.6 min” i „RUN GAP 31 min at 05:56”. ↩↩↩↩↩↩↩↩↩↩↩ -
Dane autora: log lokalnego skanera z 1 listopada 2026: krytyczne zgłoszenie z 10:03:04 wobec
spotlightknowledgedod Apple przy 74,9 procent CPU i wiersz „Critical email sent” z 10:03:06; dwa wcześniejsze alerty krytyczne tego dnia (00:48:55, shimy w ścieżce), każdy z następującą nieudaną wysyłką; oraz 14 alertów krytycznych w logu z 31 października, wśród nich wzorzec robaka AI o 22:52:57 i pięć zgłoszeń „Claude hook modified” o 22:41, z których po czterech nastąpiła nieudana wysyłka (hooki zmieniono 24 października, jak odnotowuje dziennik operacyjny z 31 października). ↩↩↩↩ -
Dane autora: zapis stanu programu digestu po digeście z 2 listopada: temat „Mon Nov 2: 71 blocks on 15 zones, 11 criticals emailed, RUNS SHORT 162/207”, okno od 2026-11-01T21:48:49Z do 2026-11-02T15:05:17Z, 162 przebiegi; log monitora odnotowuje wysyłkę o 07:05:19 PST. ↩↩
-
Dane autora: analiza luk między przebiegami wykonana skryptem na logach monitora z 1 i 2 listopada 2026. Dla okna digestu z 2 listopada (1036,5 minuty, 207 pięciominutowych slotów): 165 startów przebiegów, 4 bez „run complete” przed następnym startem; 160 zwykłych luk, mediana 5,60 minuty, średnia 5,79, minimum 5,35, w sumie 926,0 minuty (185 slotów); 4 luki ponad 10 minut, łącznie 103,0 minuty. Dla dnia kalendarzowego 2 listopada (od północy do północy, 1440 minut, 288 pięciominutowych slotów): 242 starty, o 46 mniej niż slotów, żaden niedokończony; 239 zwykłych luk, mediana 5,62 minuty, w sumie 1374,7 minuty (około 275 slotów); 2 luki ponad 10 minut, łącznie 35,8 minuty. Rozkład to przybliżona arytmetyka na podstawie tych liczb: około 25,2 slotu z powodu rytmu (160 zwykłych luk obejmuje 185,2 pięciominutowego slotu i mieści 160 przebiegów), około 15,6 slotu w trzech lukach uśpienia (93,0 minuty, 18,6 slotu, trzy przebiegi), około 1,0 slotu w 10,0-minutowej luce po przebiegu z 14:19 oraz 3 niezarejestrowane przebiegi, łącznie około 45. ↩↩↩↩↩↩↩↩↩
-
Dane autora: historia konfiguracji monitora, odczytana z jego repozytorium: uzbrojenie 31 października o 22:44 PDT (e-mail na każdy alert krytyczny i na koniec sesji); 1 listopada, 00:46 PDT (alert krytyczny włączany do e-maila o blokadzie); 1 listopada, 13:50 PST (digest włączony o 07:00, e-mail na blokadę wyłączony, alerty krytyczne obsłużone przez krawędź włączane do digestu); 1 listopada, 14:00 PST (bez zmiany konfiguracji; kod warunku WAF zmieniony tak, by liczył każde zdarzenie i wymagał kompletnej próbki). ↩↩↩↩↩↩↩
-
Dziennik operacyjny autora (Captain’s Log) z 31 października 2026: wysyłki lokalnego skanera kończące się błędem 1010 Cloudflare przy domyślnym user agencie Pythona, odtworzone z błędnym kluczem; liczba 13 nieudanych wysyłek wobec 14 alertów krytycznych tamtej nocy; e-maile z chmury, które „most likely were” doręczone. ↩↩↩↩
-
Resend, “Event Types,” dokumentacja webhooków, pobrano o 14:23:37Z: definicja
email.sent, cytowana, orazemail.deliveredjako osobne zdarzenie. ↩↩↩↩ -
Resend, “Send Email,” dokumentacja API, pobrano o 14:18:59Z: treścią odpowiedzi jest
id. ↩ -
Dane autora: 1 listopada 2026 według lokalnej godziny, z tego samego skryptu, z godziną 01:00 rozdzieloną na PDT i PST: e-maile na godzinę (22 w godzinie północnej, wszystkie niezweryfikowane), alerty włączone do digestu lub wyciszone na godzinę, ostatni e-mail o blokadzie o 13:25:57 i pierwsze powiadomienie o blokadzie włączone do digestu o 14:20:35. ↩↩↩↩
-
Cloudflare, “Querying Firewall Events with GraphQL,” dokumentacja Analytics, pobrano o 14:19:01Z: pola zapytania, w tym
action, i przykładowe wyjście z"log"i"block"; strona nie wymienia wszystkich wartości akcji. ↩↩ -
Cloudflare, “Security Events,” dokumentacja WAF, pobrano o 14:23:10Z: definicja zdarzeń bezpieczeństwa, zdanie, że jedno żądanie może wygenerować kilka zdarzeń, i zdanie o próbkowaniu, cytowane. ↩↩↩
-
Notatki projektowe autora dla lokalnego skanera, „Check fixes and false positives”: „most of the CRITICALs it raised in its first live days were its own noise”, tabela fałszywych alarmów (Python z Homebrew, Xcode, buildy aplikacji autora, samodopasowanie kontroli event tapów, shimy menedżerów wersji, wzorzec robaka AI na instrukcjach agenta z innego projektu) i wpis o podpisie kodu, cytowany; skaner sam wysyła e-mailem swoje alerty krytyczne. ↩↩↩↩↩
-
Cloudflare, “Cloudflare Alerts,” dokumentacja Notifications, pobrano o 14:19:00Z: dwie kategorie alertów, cytowane; Monitors jako zaplanowane zapytania SQL API i Platform Notifications jako wstępnie skonfigurowane alerty produktowe, jedne i drugie tworzone w panelu, z dostarczaniem e-mailem we wszystkich planach. ↩↩
-
Ewaschuk, “Monitoring Distributed Systems,” pobrano o 14:18:54Z: fragment o wezwaniach przychodzących zbyt często, cytowany. ↩↩
-
Ewaschuk, “Monitoring Distributed Systems,” pobrano o 14:18:54Z: studium przypadku zespołu segregującego alerty oraz przypis 24 odsyłający do zarządzania alarmami kardiologicznymi „for an example of alert fatigue in another context”, cytowany. ↩↩
-
Rob Ewaschuk, “My Philosophy on Alerting,” Google Doc, czytany z eksportu HTML, pobrano o 14:18:55Z: uwaga dokumentu, że jego idee stanowią fundament rozdziału książki o SRE, „Pages should be urgent, important, actionable, and real” oraz fragment o alertach opartych na przyczynach i tytuł sekcji, cytowane. ↩↩↩
-
Ewaschuk, “My Philosophy on Alerting,” pobrano o 14:18:55Z: fragment o dziennym raporcie, zastrzeżenie dotyczące odpowiedzialności i postulat wyznaczenia osoby do codziennej segregacji raportu, cytowane. ↩↩↩↩↩↩
-
Steven Thurgood, z udziałem Jess Frame, Anthony’ego Lentona, Carmeli Quinito, Antona Tolchanova i Nejca Trdina, “Alerting on SLOs,” rozdział 5 The Site Reliability Workbook (Google, O’Reilly Media), pobrano o 14:18:55Z: definicje precyzji, czułości (recall) i czasu resetu, cytowane. ↩↩
-
NIST, SP 800-61 Revision 2, Computer Security Incident Handling Guide (2012, zastąpiona), pobrano o 14:18:58Z: zdanie o „thousands or even millions”, cytowane. ↩
-
NIST, SP 800-61 Revision 3 (kwiecień 2025), pobrano o 14:18:57Z: deklaracja, że zastępuje r2, oraz zalecenie R1 w części Adverse Event Analysis, cytowane. ↩
-
Vectra AI, “2023 State of Threat Detection” (ankieta dostawcy; marzec do kwietnia 2023, zamówiona przez Vectrę, badanie terenowe Sapio Research, 2000 analityków bezpieczeństwa w organizacjach zatrudniających ponad 1000 osób na dziesięciu rynkach), pobrano o 14:22:49Z: 4484 alerty dziennie i 67 procent ignorowanych, według deklaracji respondentów. ↩↩
-
Kod autora: opis programu digestu („One email a day … in place of an email per auto-block and per WAF-handled CRITICAL”; „The digest is also the heartbeat: it goes out on a quiet day too”; wielomiesięczny okres, w którym monitor był martwy wcześniej w 2026 roku) oraz, według stanu na 2 listopada, jego reguła oczekiwanych przebiegów jako minut okna podzielonych przez pięć. ↩↩↩↩↩↩↩↩↩
-
Cloudflare, “Actions reference,” dokumentacja Ruleset Engine, pobrano o 14:19:01Z: akcje
block, challenge,skipilog, definicje challenge i log, cytowane, orazskipilogwymienione jako niekończące ewaluacji. ↩↩↩↩ -
Dane autora: krytyczne zgłoszenia według zapisanego rezultatu i kategorii z pliku zgłoszeń monitora, według daty UTC. 1 listopada: 129, z czego 118 bez rezultatu: 117 zgłoszonych, zanim zaczęto zapisywać rezultaty (wśród nich kategorie procesów, hooków i łańcucha dostaw lokalnego skanera, które nigdy go nie mają), oraz jeden alert krytyczny skanera z chmury o 14:13 PST, po zmianie, którego ostatnim zalogowanym wierszem przebiegu jest automatyczna blokada, którą wywołał (log monitora z 1 listopada). 2 listopada: 236 (160 włączonych do digestu, bo adres był zablokowany, 1 włączony, bo obsłużył go WAF, 58 wyciszonych, 14 wysłanych e-mailem, 3 lokalne bez rezultatu). ↩↩
-
Dane autora: log monitora z 1 listopada 2026: trzy przebiegi (start o 14:09:49, 14:19:46 i 23:10:31), których ostatnie wiersze przypadają około czterech minut po starcie, bez zalogowanego wiersza o watchdogu, przekroczeniu czasu czy zabiciu procesu, co autor odczytuje jako 240-sekundowy watchdog monitora (kod zabija przebieg po 240 sekundach), oraz przebieg rozpoczęty o 14:36:06, który kończy się o 14:36:34 bez „run complete”. ↩↩
-
Odtworzenie wykonane przez autora 3 listopada 2026 własnej kontroli fali formularzy monitora na kompletnych danych Cloudflare dla przedziału 18:58:23 do 19:03:23 UTC 2 listopada (10:58:23 do 11:03:23 PST), które zgłasza wykrycie przeoczone przez przebieg na żywo, z ważnością wysoką (którą monitor kieruje do digestu, a nie do e-maila ani na listę blokad), na podstawie 39 wysyłek, z których 23 odrzucono, i liczy 2143 żądania z tego adresu tam, gdzie przebieg na żywo naliczył 1914; dwie przyczyny w odczytaniu kodu monitora z tamtego dnia (okno każdego przebiegu kończyło się w chwili zapytania detektora, zanim najnowsze dane Cloudflare w pełni dotarły, a pięciominutowe spojrzenia wstecz przy przebiegach startujących w odstępach dłuższych niż pięć minut zostawiały część każdego interwału nieprzeskanowaną) oraz poprawka wprowadzona tego dnia (okna na żywo przylegają do siebie na podstawie zapisu końca poprzedniego okna i kończą się 90 sekund wcześniej; brak zapisu, zapis młodszy niż 60 sekund lub starszy niż 15 minut powoduje powrót do pięciominutowego spojrzenia wstecz; odtworzenia nigdy nie czytają zapisu), z odtworzeniem tego samego okna przez zmieniony kod dającym identyczne wykrycia, co pokazuje, że zmiana nie naruszyła detekcji w ustalonym oknie i nie testuje przylegania okien ani opóźnienia; wysyłki skanera przez formularz kontaktowy według dziennika operacyjnego autora z 2 listopada. Odtworzenie przez kod z 3 listopada zapisano wraz z resztą dowodów do tego wpisu: jego dokładne polecenia, odczytane okno i pełne wyjście detektora dla okna przebiegu oraz dla minut formularza od 18:58 do 19:05 UTC, uruchomione 3 listopada o 15:55:04 UTC. Pierwsze odtworzenie, wykonane wcześniej 3 listopada przez kod sprzed poprawki, jest zapisane w moich notatkach programu z tymi samymi liczbami; jego surowego wyjścia nie zachowano. ↩↩↩↩↩
-
Dane autora: log lokalnego skanera z 2 listopada 2026 i podgląd digestu z 3 listopada: trzy krytyczne zgłoszenia „Browser -> shell chain” o 13:50 PST, powłoka uruchamiająca
curl, nierozwiązane w pliku zgłoszeń. ↩↩ -
Dane autora: rozstrzygnięcie zapisane przy zgłoszeniu
spotlightknowledgedz 1 listopada w pliku zgłoszeń, cytowane. ↩ -
Cloudflare, “Error 1010,” dokumentacja wsparcia, pobrano o 14:19:00Z: definicja błędu i przykład z urllib w Pythonie, cytowane; strona podaje ten przykład dla żądań do hostów
*.pages.devi*.workers.devoraz domen niestandardowych Pages. ↩ -
Dziennik operacyjny autora (Captain’s Log) z 2 listopada 2026: wiersz o RUNS SHORT, cytowany. ↩
-
Dane autora: dziennik zasilania Maca (wiersze Sleep i Wake od 1 listopada, 13:40 PST): uśpienie z bezczynności o 23:21:30 i pełne wybudzenie o 00:30:05; uśpienie z bezczynności o 06:01:20 i pełne wybudzenie o 06:30:28. ↩











